🚀 Быстрый запуск локального ИИ ассистента в PhpStormДля этого Вам нужна видеокарта с RTX ядрами от NVidia или RDNA от Radeon, иначе скорость работы нейронки будет низкой.
Также нужен Docker.
Теперь можно выполнить консольные команды:
docker run -d -p 11434:11434 --gpus=all -v ollama:/root/.ollama --name ollama --restart always ollama/ollama

docker exec ollama ollama run gemma3:12b
где
gemma3:12b - это модель и её размер с сайта
Ollama. Размер модели выбирайте не больше размера видеопамяти. Например, в карточке с 12 Гб VRAM самой большой моделью будет
gemma3:12b иначе все вычисления лягут на CPU, а это очень-очень медленно. Если не нравится модель
gemma3, тогда можете выбрать любую другую на сайте.
После того как запустили Ollama в докере и загрузили в неё модель, устанавливаем плагин
ProxyAI в PhpStorm (раньше плагин назывался CodeGPT) и легко настраиваем.
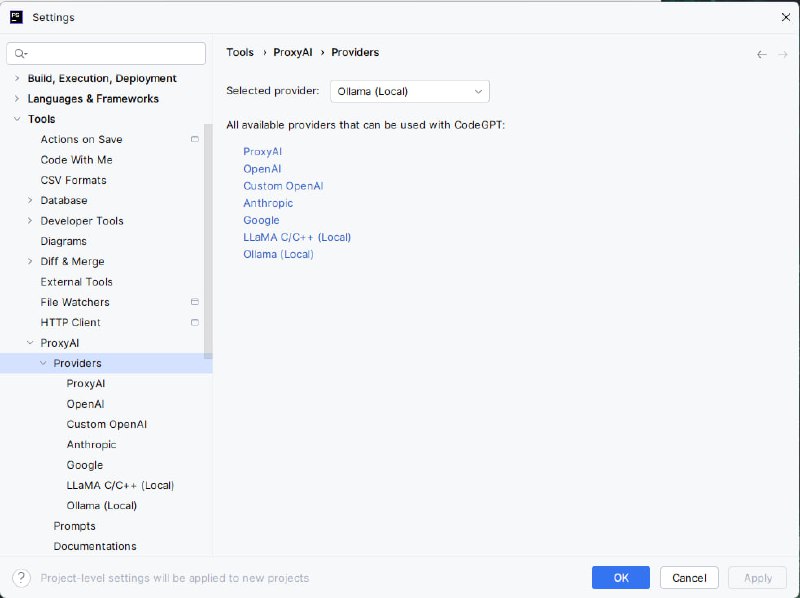
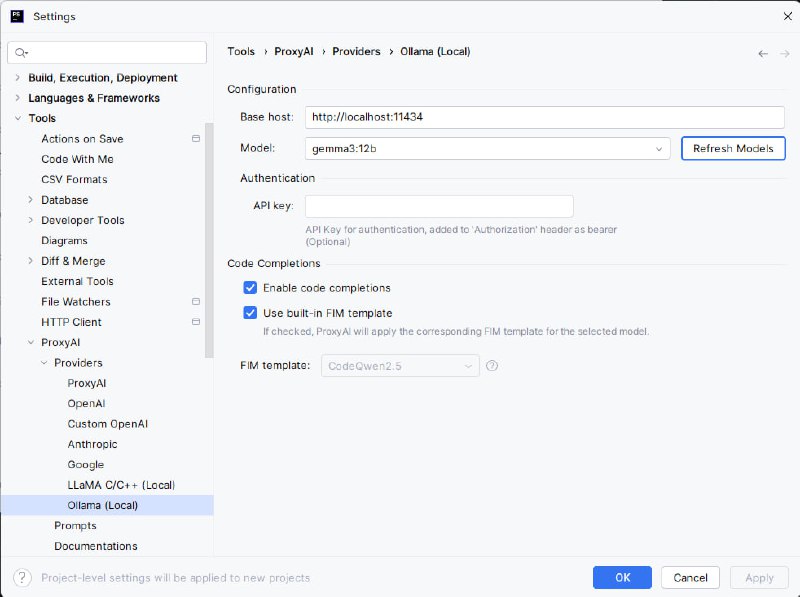
Настройки плагина находятся в разделе
File | Settings | Tools | ProxyAI.
1. Выбираем провайдер "Ollama (local)";
2. В разделе "Ollama (local)" жмём кнопку "Refresh models" для обновления списка доступных моделей и выбора нужной.
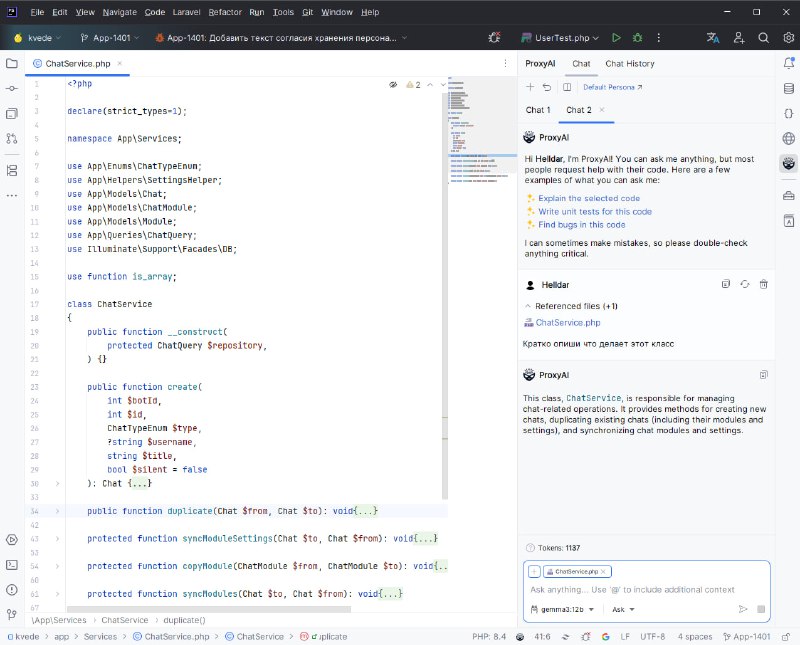
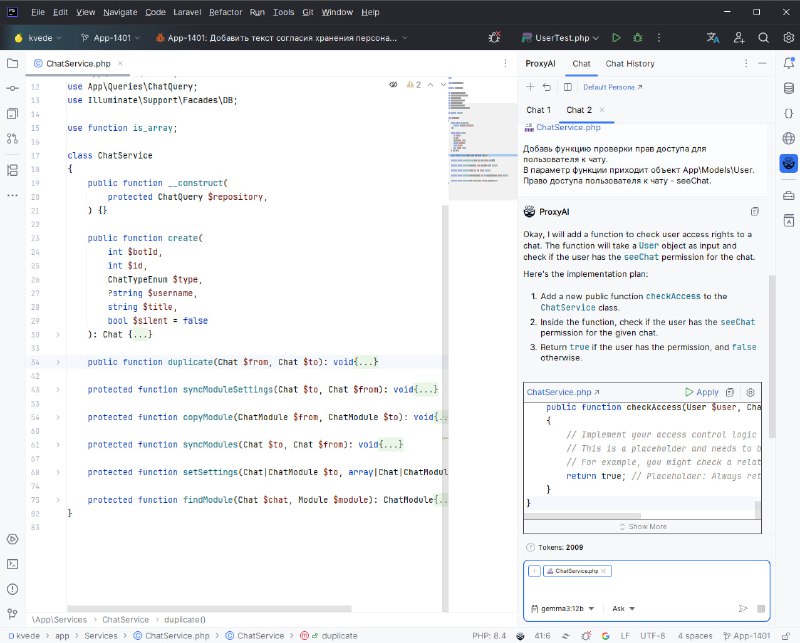
Нюанс один - не все модели отвечают на русском языке. Например,
gemma3 принципиально отвечает только по-английски, хотя понимает русский язык.